> For the complete documentation index, see [llms.txt](https://docs.seaart.ai/guide-1/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.seaart.ai/guide-1/espanol/4-parametros/4-1-modelo.md).
# 4-1 Modelo
¡Desbloquea la creación de imágenes con IA en SeaArt! Explora los Checkpoints, las LoRA y cómo se combinan para generar imágenes impactantes y únicas.
> En SeaArt, ya no es necesario implementar modelos de forma local. Simplemente puedes elegir entre los modelos en línea o incluso subir y entrenar tus propios modelos.
**Proceso de creación:**\
Elegir modelo → Ingresar *prompts* → Ajustar los parámetros correspondientes → Generar
## Checkpoint
En términos generales, tanto *LoRA* como *Checkpoint* se consideran modelos. Por lo tanto, podemos llamar al *Checkpoint* el modelo grande o modelo base. En comparación con LoRA, el modelo base es más pesado (entre 2GB y 7GB) y determina el estilo principal de la imagen final.
Mismos prompts, diferente modelo:
**Prompts:** cabello negro, princesa, volantes, de pie, cabello corto
**Checkpoints recomendados:**
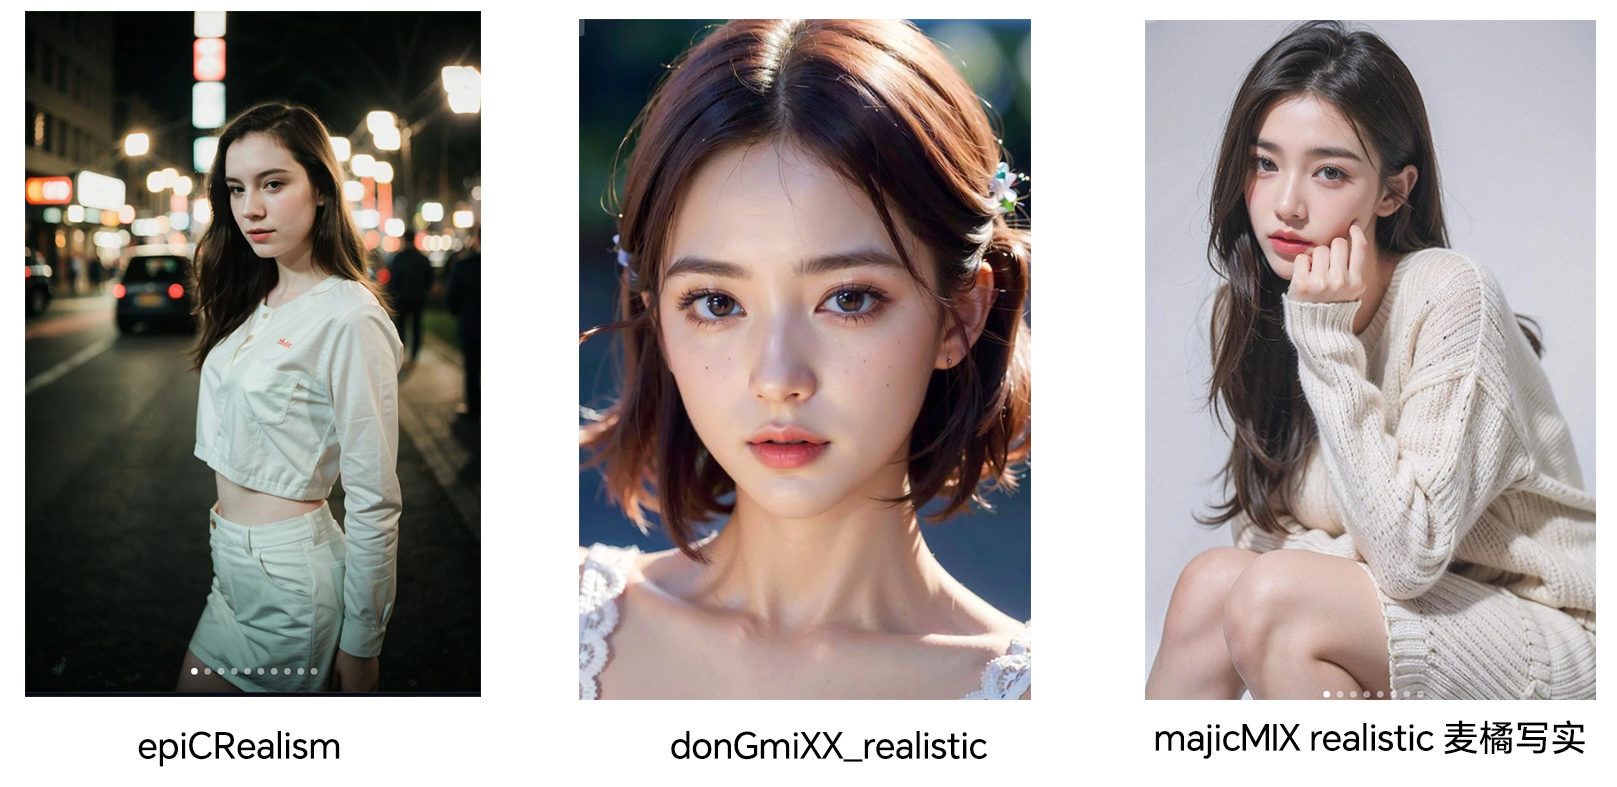
Realista:
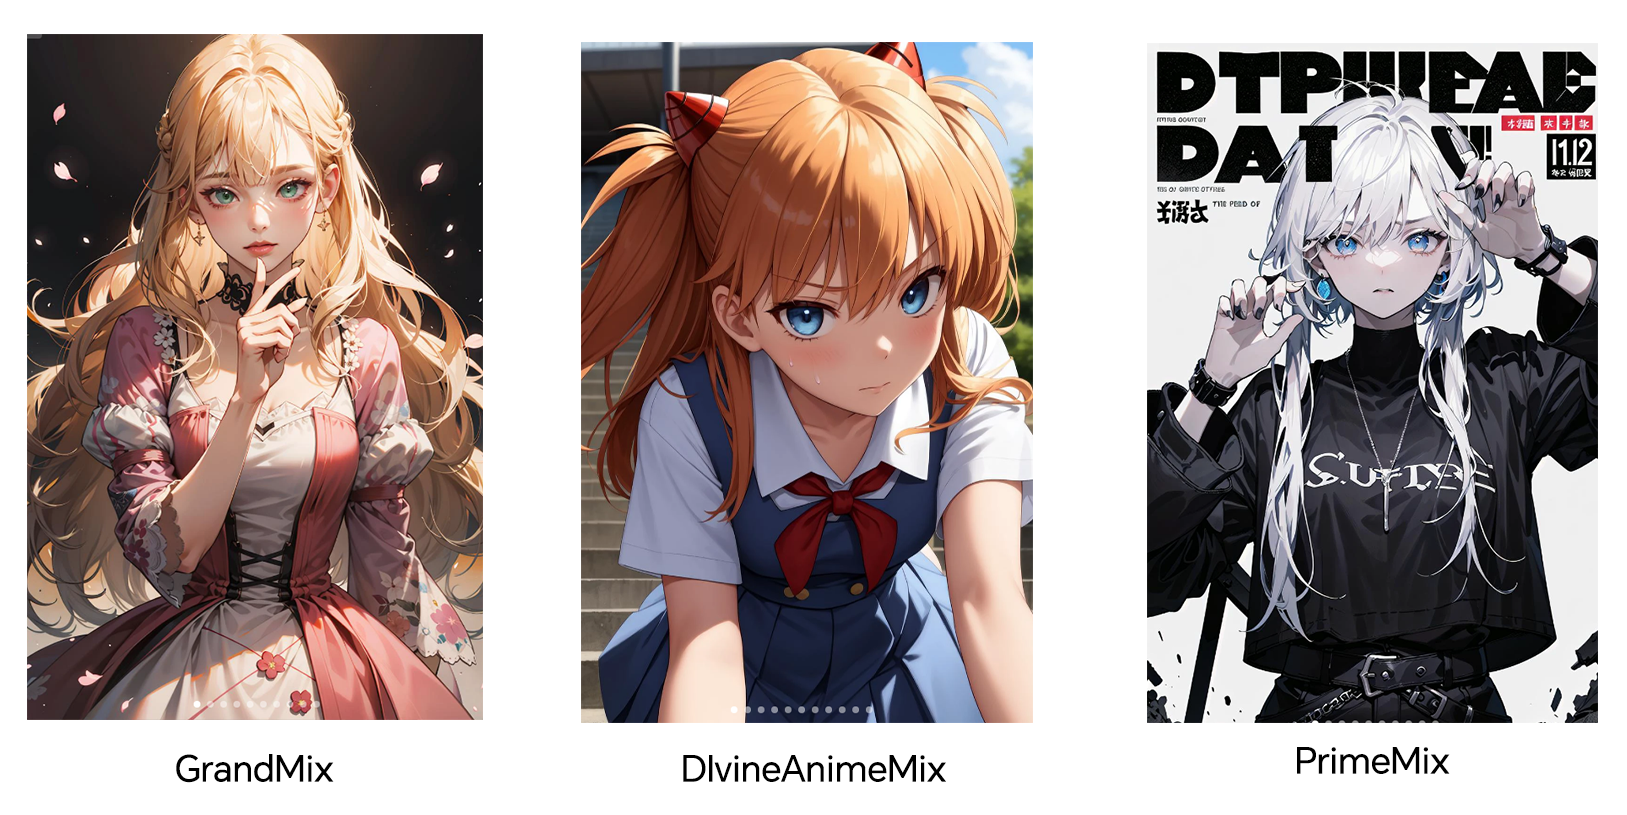
Anime:
## LoRA
LoRA suele tener un tamaño aproximado de 100 MB. Sirve para “ajustar finamente” el estilo de las imágenes, corregir la apariencia, la postura, etc. LoRA se **superpone** al Checkpoint y, al ajustar su peso, puede lograr efectos distintos. En SeaArt, se pueden apilar hasta **5 LoRAs**.
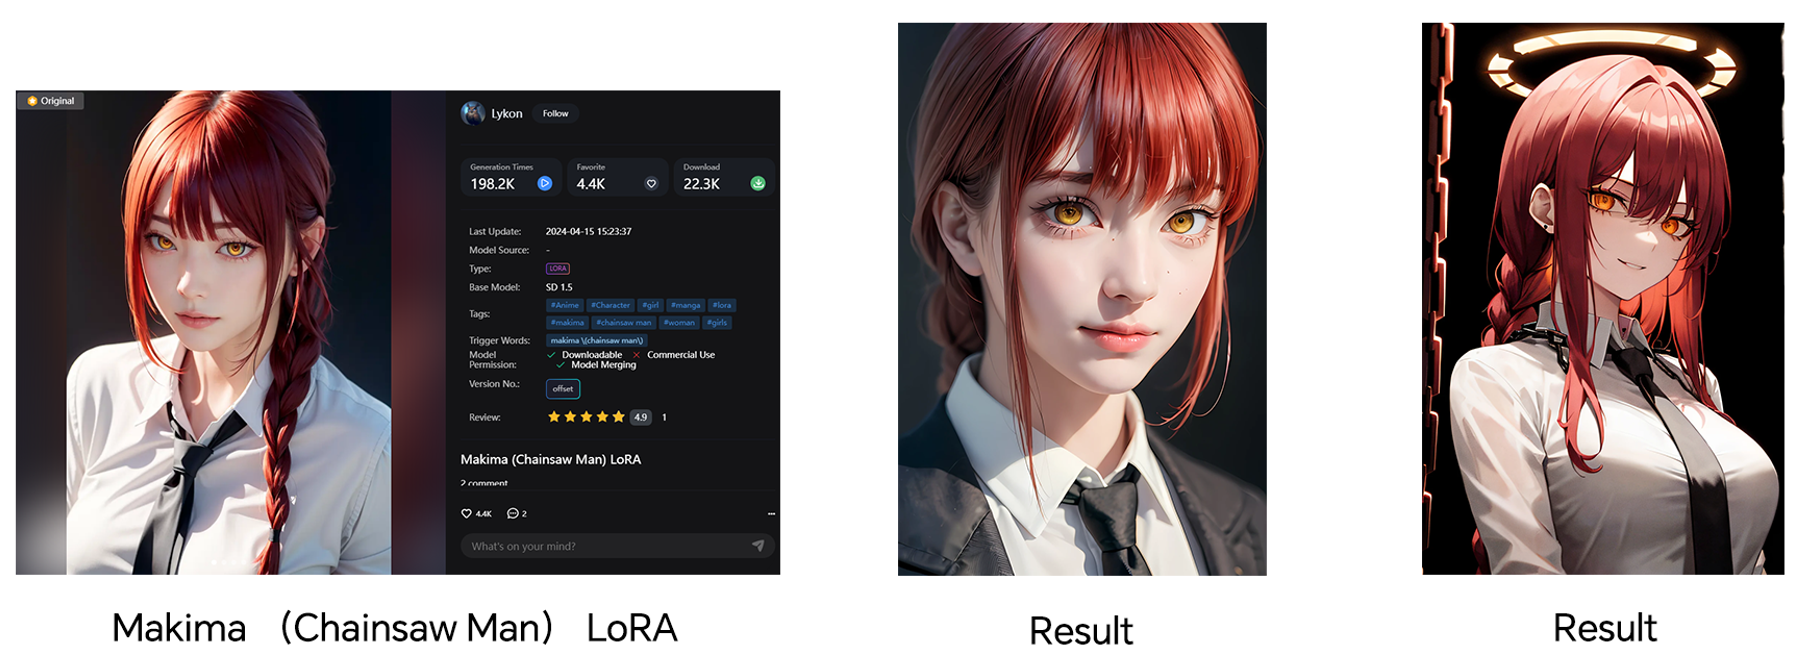
**Personaje del LoRA**: estos modelos se especializan en capturar rasgos específicos de los personajes, como su aspecto, proporciones corporales y expresiones, que suelen aparecer en dibujos animados, videojuegos u otros medios. Resultan muy útiles para la creación de fan arts, el desarrollo de juegos y proyectos de animación e ilustración.
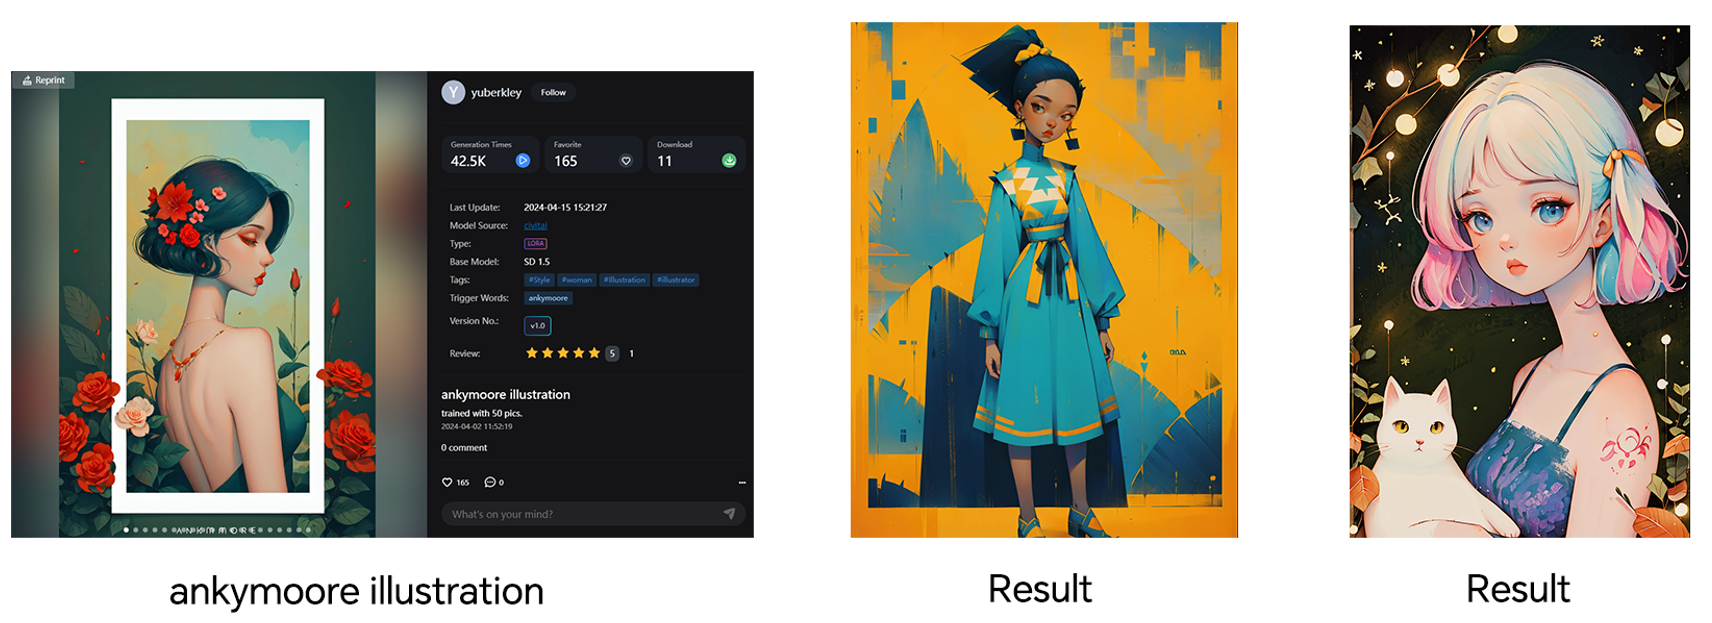
**Style LoRA:** Estos modelos están diseñados para imitar el estilo artístico de determinados artistas o movimientos artísticos. Destacan por transformar imágenes de referencia en la estética deseada, lo que los hace útiles para fines de estilización.
**Clothing LoRA:** Al igual que Style LoRA, los modelos de Clothing LoRA se concentran en estilos específicos de ropa o estética de moda. Son expertos en generar imágenes con una estética particular de vestimenta, ofreciendo aplicaciones en diseño de moda y estilismo digital.
Diferentes LoRA con el mismo Checkpoint y prompt:
**Prompt:** Una chica, vista frontal, primer plano, sentada en una silla de felpa, rostro exquisito, llena de confianza, ambiente lujoso, calidad máxima, 8k.
Añadir múltiples LoRA:
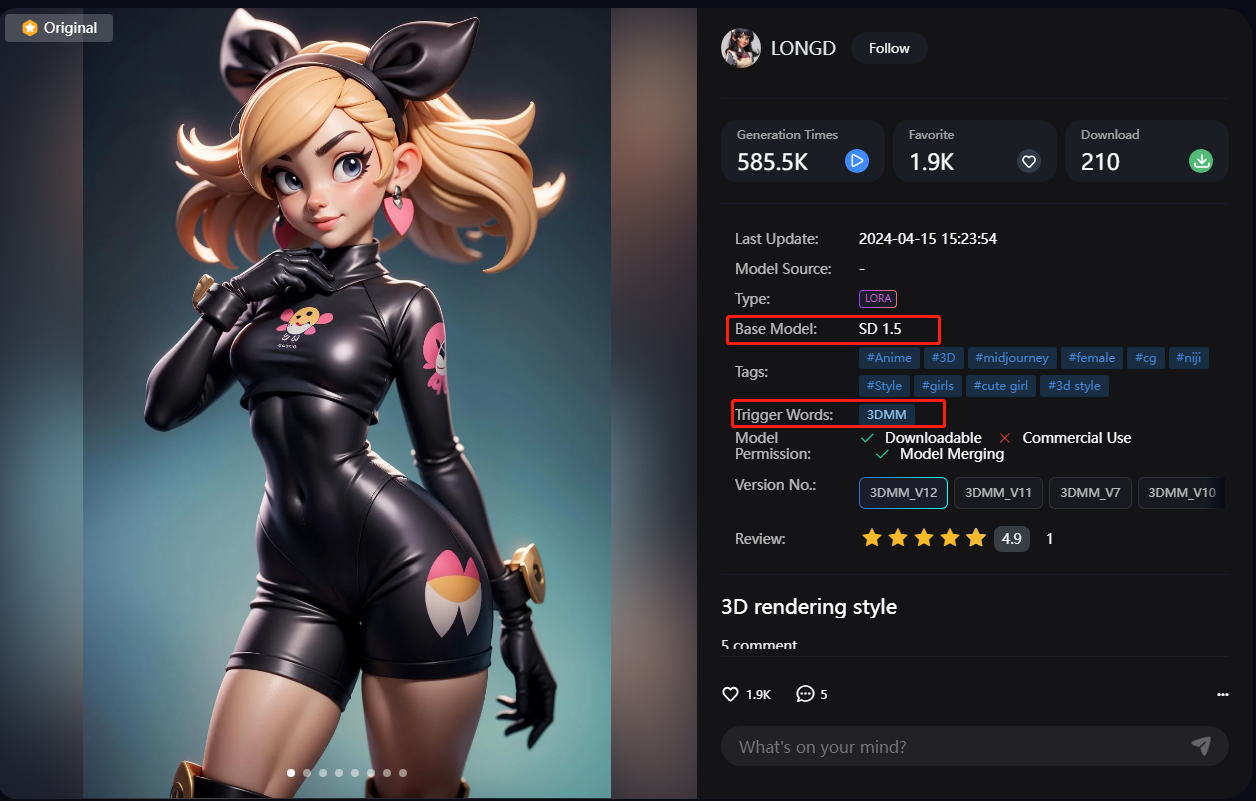
Después de añadir el LoRA de "Uniforme del Team Rocket", no solo aumentó el peso del LoRA, sino que también se añadieron *prompts* relacionados: "uniforme del Team Rocket", "letra R roja", "falda blanca", "top corto blanco", "mangas largas negras", "guantes negros hasta el codo", lo que intensificó notablemente el efecto del LoRA.
> Si el efecto no es significativo tras añadir un LoRA, puedes probar:
>
> I. Ajustar el peso del LoRA\
> II. Introducir *prompts* correspondientes
Comparado con los Checkpoints, LoRA tiene un **tiempo de entrenamiento más corto** y mayor **flexibilidad**, lo que lo hace muy eficaz para controlar detalles en las imágenes.
⚠️ **¡Atención!**
I. No se pueden usar juntos los LoRA de SD1.5 y SDXL.
II. La mayoría de los LoRA requieren palabras clave activadoras (trigger words). Incluir estas palabras en los *prompts* resalta el tema o estilo del LoRA. Aunque no siempre son obligatorias, se recomienda incluirlas para asegurar una generación estable de imágenes.
**Ejemplos de efectos con diferentes LoRA:**
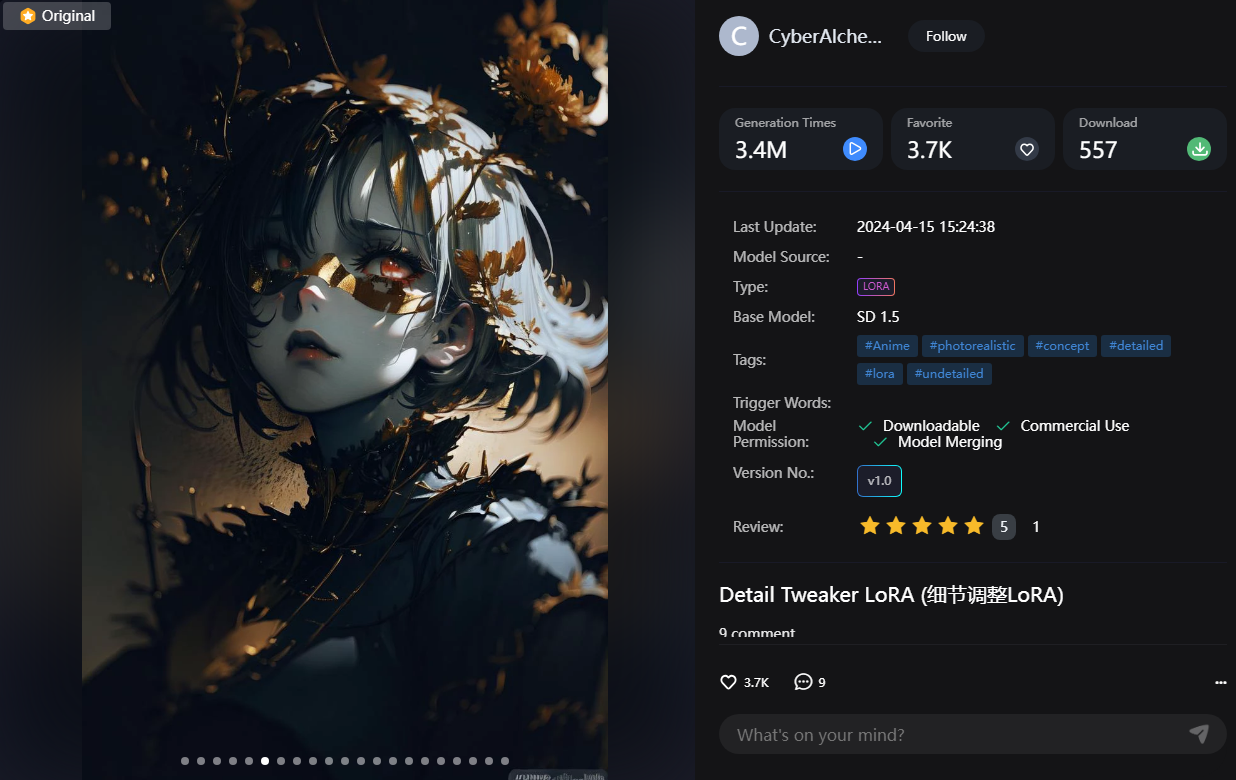
1. **Detail Tweaker LoRA:** A mayor peso, más nivel de detalle.
2. **epi\_noiseoffset**: Aumenta el contraste.
3. **Makima (Chainsaw Man) LoRA**: Corrige la apariencia del personaje.
4. **ankymoore illustration**: Cambia el estilo artístico.
\**¡LoRA tiene muchas funciones y probar diferentes LoRA puede traerte muchas sorpresas!*