> For the complete documentation index, see [llms.txt](https://docs.seaart.ai/guide-1/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.seaart.ai/guide-1/portugues/4-parametros/4-1-modelo.md).
# 4-1 Modelo
Desbloqueie a criação de imagens com IA usando SeaArt! Explore Checkpoints, Loras e sua interação para gerar visuais impressionantes e únicos.
> **No SeaArt, não há mais necessidade de implantação local de modelos. Você pode simplesmente escolher online, ou até mesmo carregar e treinar seus próprios modelos.**
**Processo de Criação**: Escolher modelo - Inserir prompts - Ajustar parâmetros relevantes - Criar
## Checkpoint
Geralmente falando, tanto Lora quanto Checkpoint são referidos como modelos. Portanto, podemos chamar Checkpoint de modelo grande ou modelo base. Comparado ao Lora, o modelo grande é relativamente maior, variando de 2GB a 7GB, e determina o estilo principal da imagem final.
Mesmos prompts, modelo diferente:
Prompts: cabelo preto, princesa, babados, em pé, cabelo curto
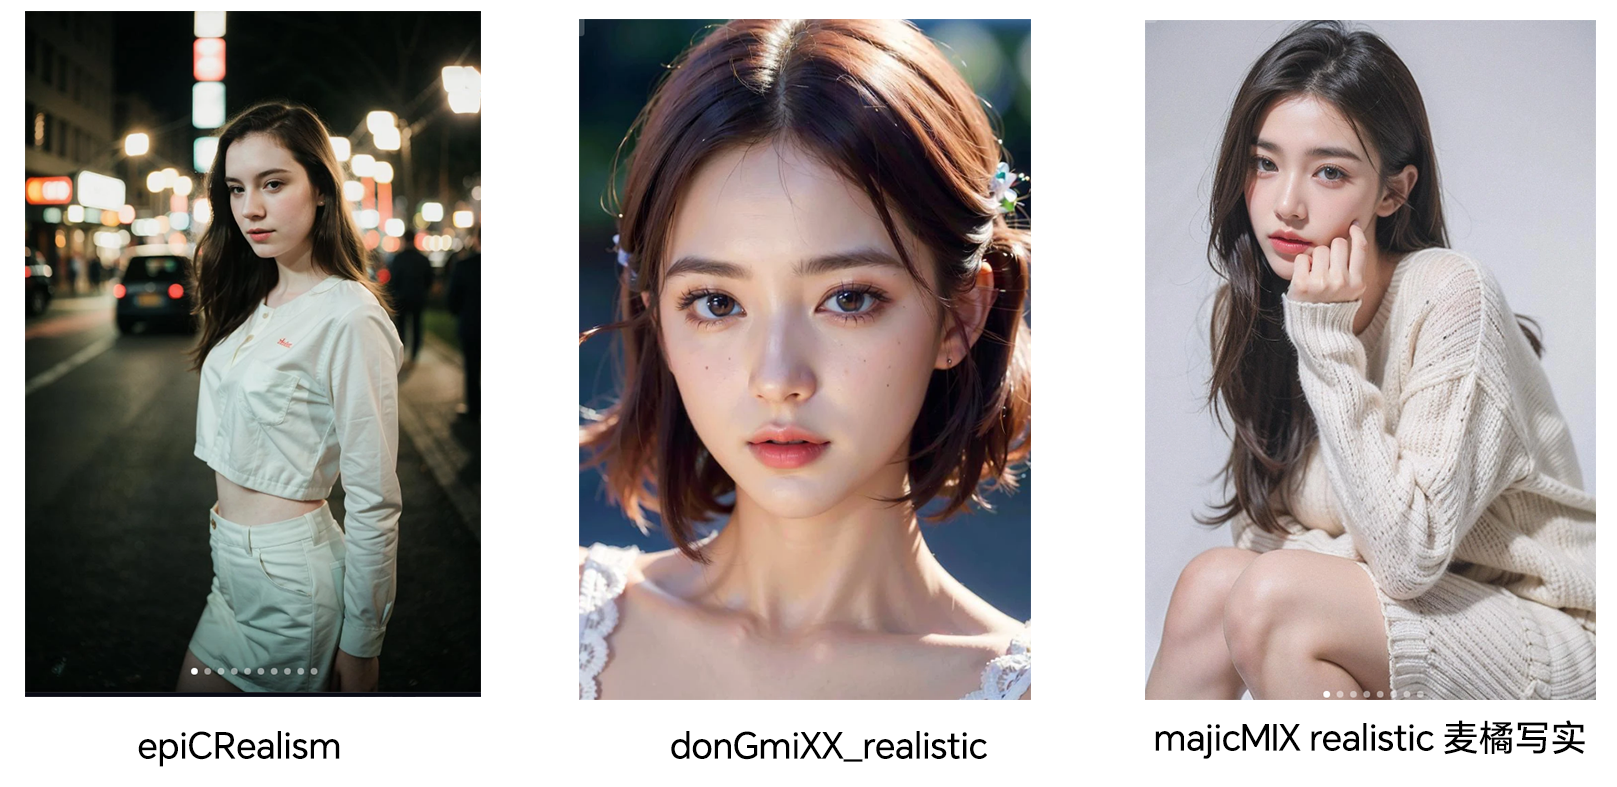
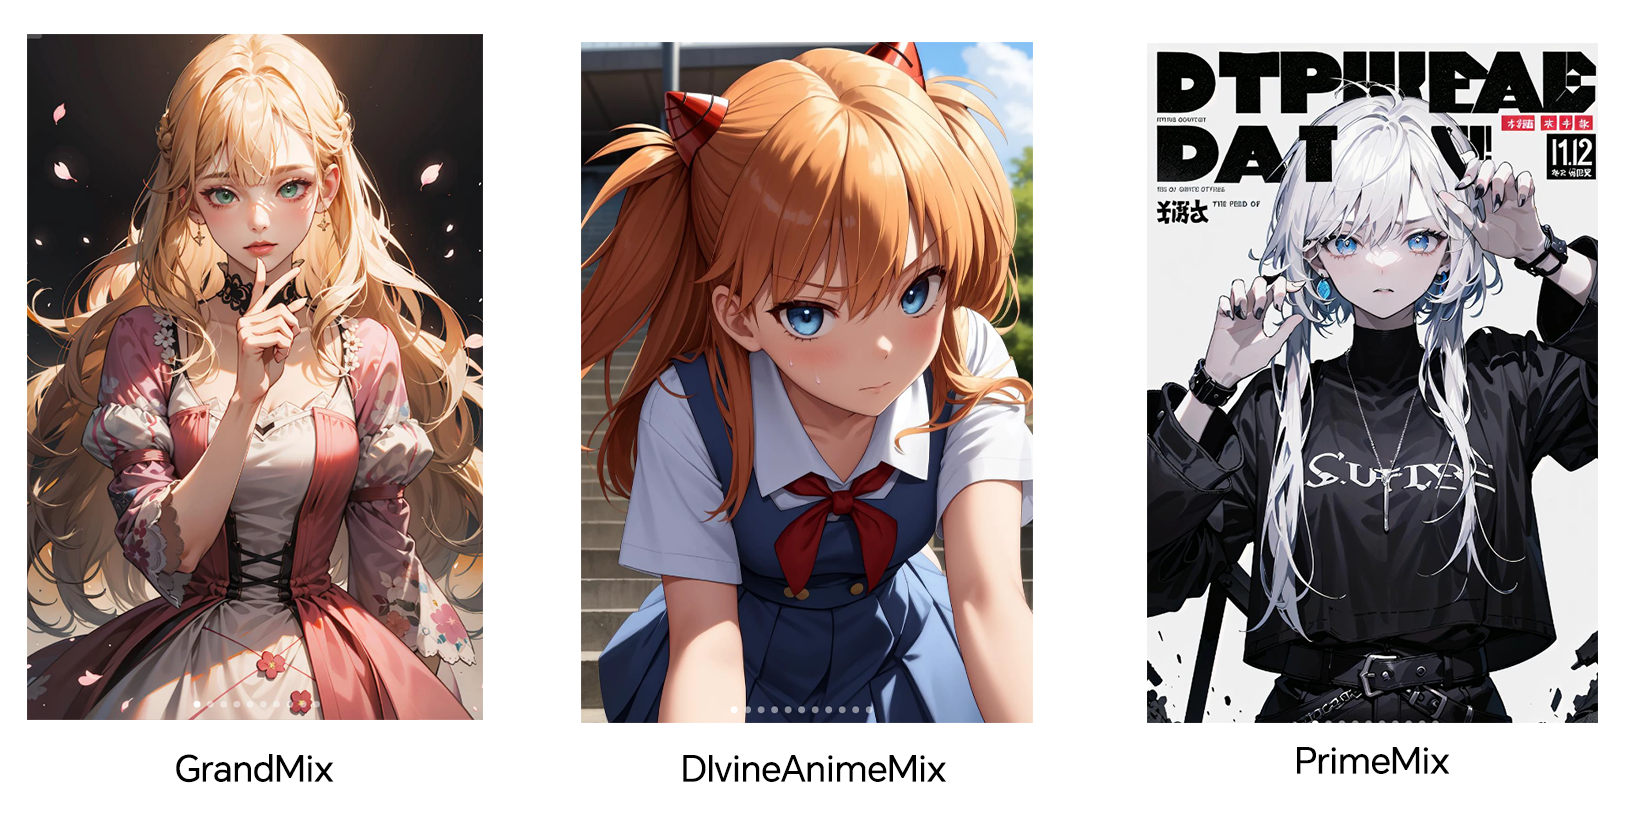
**Checkpoint Recomendado:**
Realista:
Anime:
## LoRA
LoRA tipicamente tem cerca de 100MB de tamanho. Pode "ajustar finamente" o estilo das imagens, corrigir a aparência, postura, etc. Sobrepondo o Checkpoint, ajustar pesos pode alcançar diferentes efeitos. No SeaArt, Lora pode empilhar até 5.
**LoRA de Personagem:** Esses modelos se especializam em capturar características específicas de personagens, como aparência, proporções corporais e expressões, comumente encontradas em desenhos animados, videogames ou outras mídias. Eles se mostram valiosos para criação de arte de fãs, desenvolvimento de jogos e projetos de animação/ilustração.
**LoRA de Estilo:** Esses modelos são adaptados para imitar o estilo artístico de artistas específicos ou movimentos artísticos. Eles se destacam em transformar imagens de referência na estética desejada, tornando-os úteis para propósitos de estilização.
**LoRA de Roupas**: Similar ao LoRA de Estilo, modelos LoRA de Roupas focam em estilos específicos de roupas ou estéticas de moda. Eles são hábeis em gerar imagens com uma estética particular de roupas, oferecendo aplicações em design de moda e estilização digital.
Lora diferente com o mesmo Checkpoint e prompt:
Prompt: Uma garota, vista frontal, close-up, sentada em uma cadeira de pelúcia, rosto requintado, cheia de confiança, atmosfera luxuosa, qualidade superior, 8k.
Adicionar múltiplos Loras:
Após adicionar o Uniforme Team Rocket, não apenas aumentou o peso do Lora, mas também adicionou prompts relacionados para Lora: "uniforme da Equipe Rocket", "letra R vermelha", "saia branca", "top curto branco", "mangas longas pretas", "luvas pretas até o cotovelo", tornando o efeito do Lora mais pronunciado.
> Se o efeito não for significativo após adicionar Lora, podemos tentar:
>
> I. Ajustar o peso do Lora
>
> II. Inserir prompts correspondentes
Comparado ao Checkpoint, Lora tem tempo de treinamento mais curto e maior "flexibilidade", e pode exercer bons efeitos no controle de imagens.
Atenção!!!
I. Lora do SD1.5 e SDXL não podem ser usados juntos.
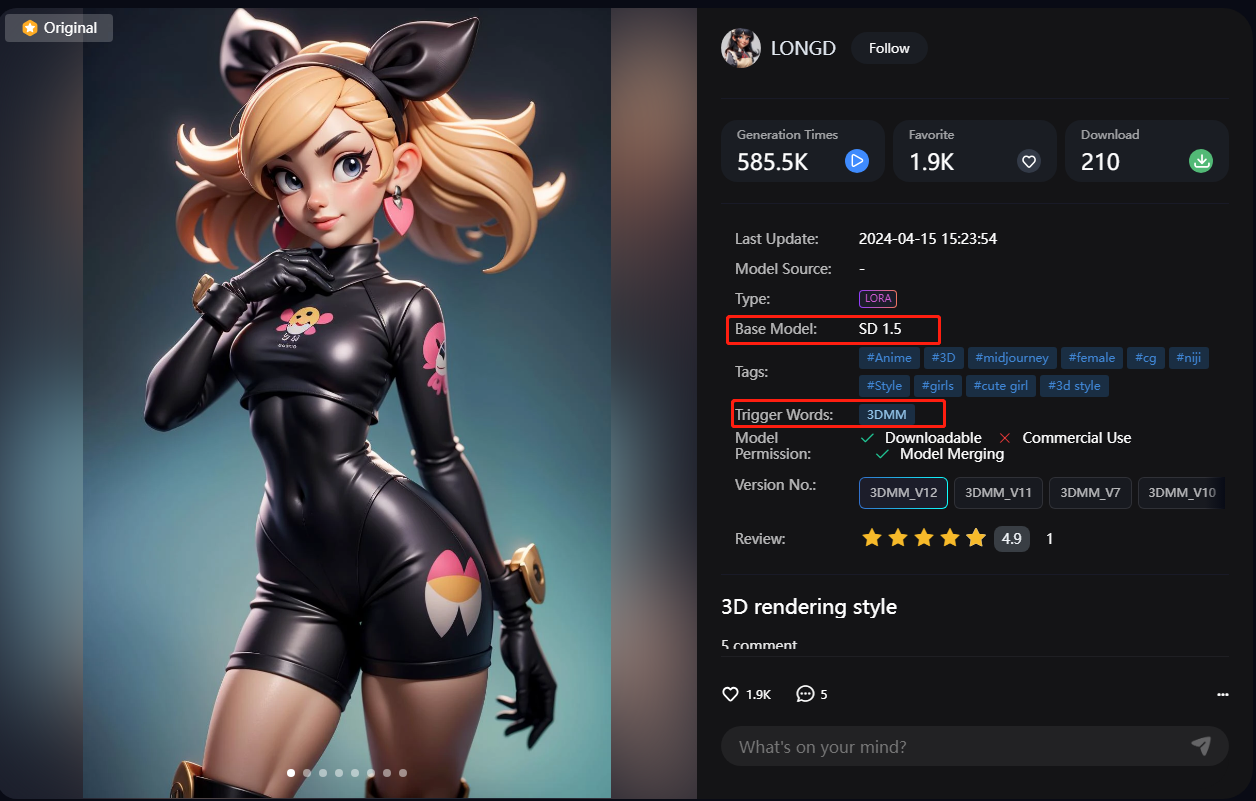
II. A maioria dos Lora requer palavras-gatilho. Incluir essas palavras nos prompts pode enfatizar o sujeito único ou estilo fornecido pelo Lora. Essas palavras-gatilho nem sempre são necessárias, mas é recomendado incluí-las nos prompts para garantir geração estável de imagens.
**Diferentes Efeitos de Lora:**
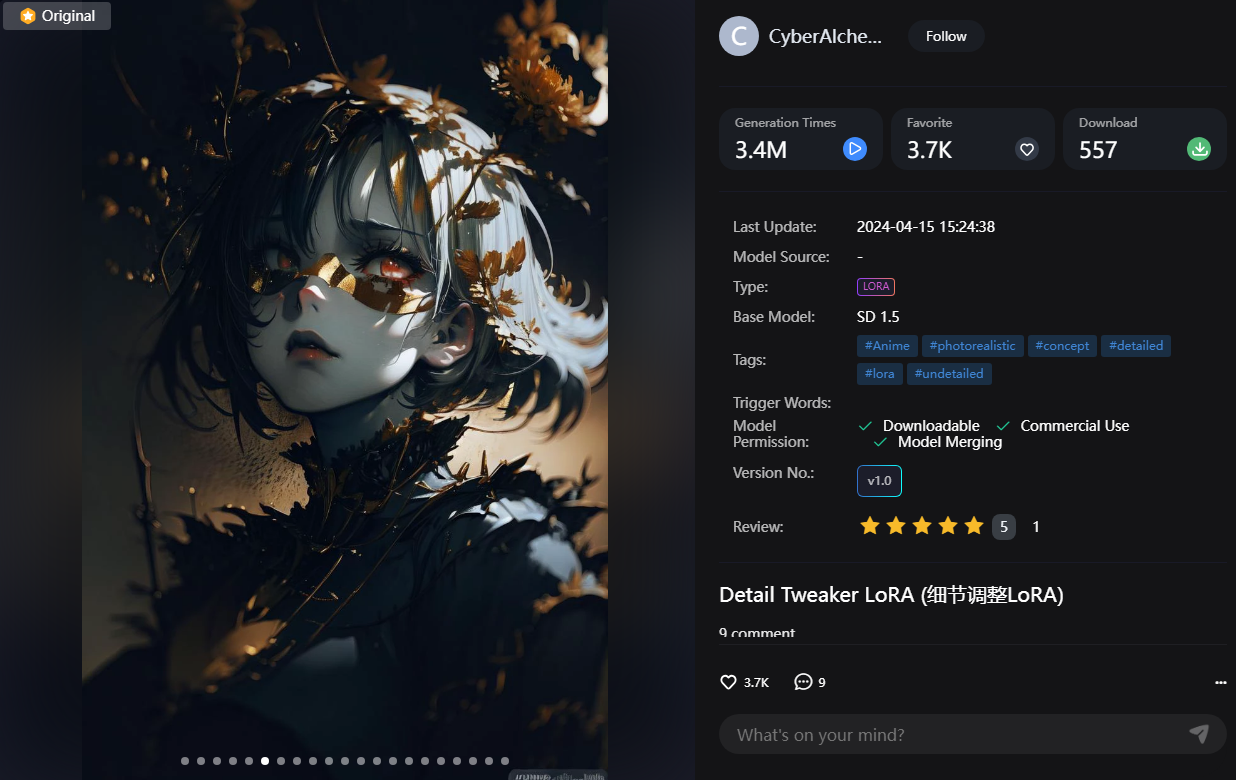
1. **Detail Tweaker LoRA:** Quanto maior o peso, mais detalhes.
2. **epi\_noiseoffset**: Aumenta o contraste.
3. **Makima (Chainsaw Man) LoRA**: Fixa a imagem do personagem.
4. **ankymoore illustration**: Modifica o estilo artístico.
*\*Lora tem muitas funções, experimentar diferentes Loras pode trazer mais surpresas!*